Der Durchschnitt ist eine ausgesprochen nützliche mathematische Erfindung. Er beschreibt Verteilungen, macht Entwicklungen vergleichbar und hilft, komplexe Zusammenhänge auf handhabbare Größen zu reduzieren. Problematisch wird es erst, wenn wir vergessen, dass der Durchschnitt eine Beschreibung ist und keine Bewertung. Aus dem statistisch Häufigen wird dann das gesellschaftlich Erwartete und irgendwann das vermeintlich Richtige.
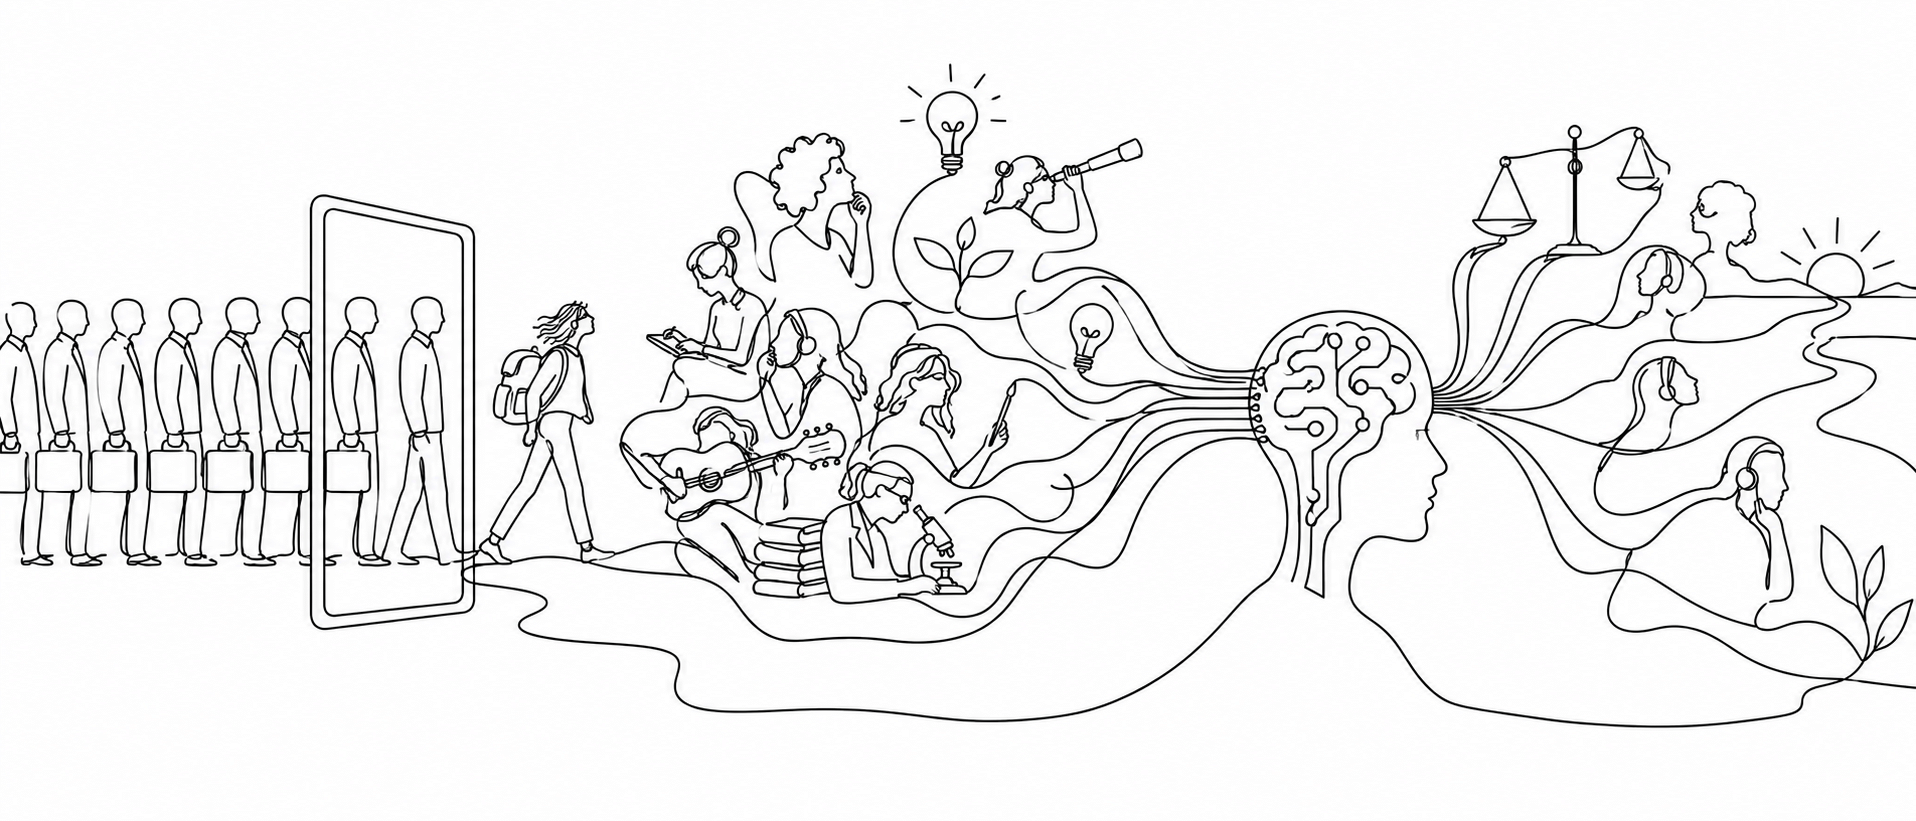
Schulen, Unternehmen und Verwaltungen orientieren sich an einem Menschen, der morgens pünktlich aufsteht, acht Stunden gleichmäßig leistungsfähig bleibt, Geräusche ausblendet, soziale Signale zuverlässig interpretiert und seine Aufmerksamkeit genau dort einsetzt, wo der Stundenplan oder die Geschäftsführung sie gerade benötigt.
Ich würde diesen Menschen gern kennenlernen. Vermutlich existiert er ungefähr so häufig wie eine Familie mit 1,37 Kindern.
Wenn Statistik zur moralischen Instanz wird
Der französische Philosoph und Mediziner Georges Canguilhem unterschied zwischen statistischer Normalität und Normativität. Was häufig vorkommt, muss weder gesund noch erstrebenswert sein. Entscheidend ist vielmehr, ob ein Lebewesen unter unterschiedlichen Bedingungen tragfähige Lebensweisen entwickeln kann.
Damit stellt sich eine Frage, die gerade im Zusammenhang mit Neurodivergenz unbequem wird: Warum beurteilen wir Menschen danach, wie gut sie einer vorgegebenen Umwelt entsprechen, statt gelegentlich zu untersuchen, wie gut diese Umwelt den Menschen entspricht?
Der Philosoph Michel Foucault ging noch einen Schritt weiter. In seiner Analyse gesellschaftlicher Disziplinierung beschrieb er, wie Institutionen Menschen beobachten, vergleichen und anhand etablierter Normen beurteilen. Die Norm ist damit nicht bloß eine Beschreibung, sondern ein Instrument gesellschaftlicher Macht.
Besonders elegant funktioniert dieser Mechanismus, weil Normalität sich niemals rechtfertigen muss.
Ein Kind mit ADHS muss erklären, weshalb es nicht stillsitzt. Niemand verlangt vom stillsitzenden Kind den Nachweis, dass seine Sitzfähigkeit einen pädagogischen Mehrwert besitzt. Wer im Großraumbüro unter permanenter Geräuschkulisse nicht konzentriert arbeiten kann, gilt als empfindlich. Wer dort acht Stunden problemlos verbringt, gilt als belastbar, selbst wenn seine tatsächliche Arbeitsleistung überschaubar bleibt.
Der Durchschnitt genießt gesellschaftlich eine Art Unschuldsvermutung. Abweichung dagegen ist erklärungspflichtig.
Der Normalmensch ist eine organisatorische Sparmaßnahme
Natürlich haben Standards ihren Sinn. Eine Schule kann nicht für jedes Kind einen vollständig individuellen Stundenplan entwickeln, und eine Verwaltung benötigt nachvollziehbare Verfahren. Standardisierung reduziert Komplexität und Kosten.
Der Fehler entsteht dort, wo wir organisatorische Zweckmäßigkeit mit menschlicher Qualität verwechseln. Ein Mitarbeiter, der in das bestehende Arbeitsmodell passt, ist nicht automatisch besser geeignet als einer, der andere Rahmenbedingungen benötigt. Ein Schüler, der Prüfungsformate mühelos bewältigt, besitzt nicht zwangsläufig mehr Wissen als einer, dessen Fähigkeiten sich anders zeigen.
In meinem Bild vom Mischpult der Neurodiversität besteht menschliche Wahrnehmung und Kognition aus zahlreichen unterschiedlich eingestellten Reglern. Aufmerksamkeit, Reizverarbeitung, Impulskontrolle, Kreativität, soziale Wahrnehmung und Detailorientierung bilden kein einheitliches Paket.
Was bei einer Tätigkeit stört, kann bei einer anderen ausgesprochen wertvoll sein. Hohe Detailorientierung kann Besprechungen mühsam machen und gleichzeitig bei der Fehlersuche entscheidend sein. Ungewöhnliche Assoziationen können Gespräche erschweren und wissenschaftliche Hypothesen ermöglichen.
Weder neurotypisch noch neurodivergent bedeutet deshalb automatisch besser. Entscheidend ist die Passung zwischen Fähigkeiten, Anforderungen und Umgebung.
Ist künstliche Intelligenz neurotypisch?
Mit künstlicher Intelligenz bekommt diese Diskussion eine zusätzliche Dimension. Große Sprachmodelle werden mit gewaltigen Mengen menschlich erzeugter Texte trainiert. Sie lernen statistische Zusammenhänge, sprachliche Muster und kontextabhängige Wahrscheinlichkeiten.
Auf den ersten Blick müsste eine solche KI geradezu neurotypisch sein. Schließlich stammt ein erheblicher Teil der sprachlichen Überlieferung aus einer Gesellschaft, deren Mehrheit als neurotypisch gilt und deren Institutionen überwiegend an entsprechenden Verhaltensmustern orientiert sind.
Doch diese Überlegung besitzt einen interessanten Haken.
Die Menschen, die Texte produzieren, Bücher schreiben, wissenschaftliche Erkenntnisse veröffentlichen, Kunst schaffen oder ungewöhnliche Ideen formulieren, bilden keineswegs eine repräsentative Stichprobe der Gesamtbevölkerung. Schon die Entscheidung, über ein Thema intensiv nachzudenken und anschließend einen längeren Text darüber zu verfassen, ist eine Form der Selbstselektion.
Und gerade neurodivergente Menschen können Fähigkeiten mitbringen, die in solchen Bereichen besonders wertvoll sind: intensive Spezialinteressen, ungewöhnliche Assoziationen, ausgeprägte Mustererkennung, Beharrlichkeit oder die Bereitschaft, etablierte Denkweisen infrage zu stellen.
Allerdings wäre es wissenschaftlich unseriös, daraus ohne Weiteres abzuleiten, neurodivergente Menschen seien generell kreativer oder unter Autoren überrepräsentiert. Kreativität ist kein diagnostisches Merkmal, und die Forschung liefert je nach untersuchter Eigenschaft, Personengruppe und Kreativitätsmaß unterschiedliche Ergebnisse. Ebenso wenig kennen wir die neurologische Zusammensetzung der Autoren großer KI-Trainingskorpora.
Die Hypothese bleibt trotzdem spannend: Vielleicht ist der Anteil neurodivergent geprägter Perspektiven an der schriftlichen Wissensproduktion größer als ihr Anteil an der Bevölkerung. Und damit hätten wir ein durchaus reizvolles Forschungsgebiet an der Schnittstelle von Psychologie, Neurowissenschaften, Literaturwissenschaft und künstlicher Intelligenz.
Wie verteilen sich neurotypische und neurodivergente Menschen tatsächlich unter Autoren, Wissenschaftlern und anderen Produzenten schriftlichen Wissens? Unterscheiden sich ihre Beiträge hinsichtlich Originalität, gedanklicher Verknüpfungen oder sprachlicher Muster? Und falls solche Unterschiede nachweisbar wären: In welchem Umfang finden sie Eingang in die Trainingsdaten großer Sprachmodelle, und was bleibt nach deren statistischer Verarbeitung und anschließender Modellabstimmung davon übrig?
Besonders interessant wäre dabei die umgekehrte Perspektive: Könnten wir mithilfe von KI überhaupt untersuchen, welche unterschiedlichen kognitiven Herangehensweisen sich in Texten niederschlagen, ohne dabei aus sprachlichen Eigenheiten unzulässige neurologische Diagnosen abzuleiten? Schließlich lässt sich Neurodivergenz nicht zuverlässig aus einem Schreibstil herauslesen. Eine solche Forschung müsste mit freiwillig erhobenen, belastbaren Angaben der Autoren arbeiten und zugleich zwischen Kreativität, Produktivität, Veröffentlichungschancen und tatsächlicher Repräsentation in Trainingsdaten unterscheiden.
Vielleicht entdecken wir dabei, dass KI wesentlich mehr neurodivergente Denkmuster verarbeitet, als ihre betont durchschnittlichen Antworten vermuten lassen. Vielleicht stellt sich aber auch heraus, dass wir die kreative Sonderstellung neurodivergenter Menschen überschätzen. Beides wäre ein Erkenntnisgewinn. Und möglicherweise wäre gerade die Zusammenarbeit von KI-Forschung und Psychologie geeignet, eine Frage zu beantworten, die bislang erstaunlich selten gestellt wird: Wie viel menschliche Vielfalt steckt eigentlich in einer künstlichen Intelligenz – und wie viel davon lassen wir sie wieder ausgeben?
Wer schreibt, ist nicht automatisch repräsentativ
Hier müssen wir drei unterschiedliche Verteilungen auseinanderhalten: die neurologische Zusammensetzung der Bevölkerung, die Zusammensetzung der Autoren und die Häufigkeit ihrer Texte in KI-Trainingsdaten.
Ein Mensch, der ein Buch schreibt, hinterlässt mehr verwertbare Sprache als jemand, der seine Gedanken ausschließlich im persönlichen Gespräch äußert. Ein Wissenschaftler, der jahrzehntelang publiziert, prägt die schriftliche Wissensbasis stärker als jemand, dessen praktische Erkenntnisse niemals veröffentlicht werden. Und ein besonders produktiver Autor kann in einem Textkorpus vielfach vertreten sein, obwohl er statistisch selbstverständlich nur eine einzige Person ist. Und trotzdem kann der produktive Geist auch permanent danebenliegen!
Hinzu kommen Veröffentlichungsbarrieren, Bildungszugang, Sprache, Urheberrecht und die Auswahlmechanismen der Datensammlung. Ein hochkreativer Mensch, dessen Texte niemals digitalisiert werden, beeinflusst das Training möglicherweise überhaupt nicht. Ein mittelmäßiger, aber ausgesprochen produktiver Verfasser von Suchmaschineninhalten dagegen unter Umständen erheblich.
Die Trainingsdaten einer KI sind deshalb weder ein demokratisches Abbild der Bevölkerung noch ein unverfälschter Querschnitt menschlicher Intelligenz. Sie repräsentieren zunächst das, was geschrieben, veröffentlicht, gesammelt, gefiltert und schließlich für das Training gewichtet wurde.
Die Frage lautet also nicht nur, wer denkt, sondern auch, wessen Gedanken überhaupt in die Maschine gelangen.
Ist KI damit möglicherweise neurodivers?
Nein, jedenfalls nicht im eigentlichen Sinn. Eine KI besitzt kein menschliches Nervensystem, keine neurologische Entwicklungsgeschichte und keine subjektive Erfahrung von Reizüberflutung, Hyperfokus oder sozialer Ausgrenzung. Sie kann deshalb weder neurotypisch noch neurodivergent sein.
Aber sie kann Denkweisen reproduzieren, die aus unterschiedlichen menschlichen Perspektiven stammen. Sie kann konventionelle Argumentationsmuster ebenso nachbilden wie ungewöhnliche gedankliche Verbindungen. In diesem begrenzten Sinn enthält ihr statistisches Modell Spuren menschlicher Neurodiversität, ohne selbst neurodivergent zu sein.
Damit entsteht ein Paradox: Eine KI könnte durch vielfältige menschliche Autoren ungewöhnliche Denkansätze gelernt haben, während ihre spätere Abstimmung auf hilfreiche, höfliche und erwartungskonforme Antworten genau diese Abweichungen wieder abschwächt.
Das ist keineswegs zwangsläufig. Aber es ist ein reales Gestaltungsrisiko. Eine Maschine, die aus vielfältigen Gedanken lernt, muss diese Vielfalt nicht in gleicher Weise wiedergeben. Training, Nachtraining, Bewertungsverfahren und Produktvorgaben beeinflussen, welche Antworten bevorzugt werden.
Wir könnten also ausgerechnet jene Technologie, die Zugang zu unterschiedlichsten Denkweisen eröffnet, auf den gesellschaftlich verträglichsten Mittelwert zurechttrimmen.
Wenn statistische Vernunft zur Autorität wird
Damit berühren wir zwei grundsätzliche Probleme künstlicher Intelligenz: die Frage nach gesellschaftlicher Teilhabe und die nach der Verlässlichkeit maschinell erzeugter Erkenntnisse. Beide hängen enger zusammen, als es zunächst erscheint, denn wer bestimmt, was als normal gilt, beeinflusst zugleich, welche Fähigkeiten anerkannt und welche Erkenntnisse ernst genommen werden.
Eine KI kann neurodivergenten Menschen helfen, Kommunikationsbarrieren zu überwinden, Gedanken zu strukturieren oder Informationen in einer individuell geeigneten Form aufzubereiten. Dieselbe Technologie kann jedoch neue Barrieren errichten, wenn sie menschliches Verhalten anhand statistisch typischer Muster bewertet. Was technisch als Abweichung erscheint, wird dann möglicherweise als mangelnde Eignung interpretiert. Die gesellschaftliche Norm erhält eine algorithmische Verstärkung, ohne dadurch auch nur einen Deut vernünftiger zu werden.
Noch grundsätzlicher wird das Problem bei der Erkenntnis. Sprachmodelle orientieren sich an erlernten Wahrscheinlichkeiten, doch statistische Plausibilität ist kein Wahrheitskriterium. Eine ungewöhnliche, aber zutreffende Erklärung kann weniger wahrscheinlich erscheinen als eine vertraute, aber falsche. Hinzu kommt, dass die Abstimmung von KI-Systemen auf erwünschte Antworten dazu führen kann, dass sie etablierte Sichtweisen bevorzugen, statt deren Voraussetzungen kritisch zu hinterfragen.
Gerade wissenschaftlicher Fortschritt lebt jedoch davon, dass jemand eine allgemein akzeptierte Erklärung nicht akzeptiert. Eine KI, die vor allem das bereits Bekannte überzeugend reproduziert, wäre damit möglicherweise ein hervorragender Assistent für die Verwaltung vorhandenen Wissens, aber ein ausgesprochen mittelmäßiger Partner bei der Suche nach neuem.
Umgekehrt ist Originalität allein noch kein Erkenntnisgewinn. Nicht jede ungewöhnliche Hypothese ist richtig, und nicht jede Minderheitenposition verdient dieselbe Anerkennung wie eine empirisch gut abgesicherte Theorie. Entscheidend ist deshalb die Fähigkeit, zwischen statistischer Häufigkeit, argumentativer Plausibilität und überprüfbarer Wahrheit zu unterscheiden.
Genau darin liegt für mich eine der zentralen Herausforderungen künstlicher Intelligenz: Sie sollte uns nicht nur dabei unterstützen, schneller zu Antworten zu gelangen, sondern auch dabei, deren Voraussetzungen zu erkennen, Gegenargumente zu entwickeln und die Grenzen unseres Wissens offenzulegen. Andernfalls automatisieren wir nicht die Erkenntnis, sondern lediglich die Gewissheit, mit der wir unsere bisherigen Irrtümer vortragen.
Die Norm muss ihre Eignung nachweisen
Vielleicht liegt hier die eigentliche Konsequenz aus Canguilhem, Foucault und der Diskussion über Neurodivergenz: Nicht nur Menschen, die von einer Norm abweichen, sollten ihre Eignung erklären müssen. Auch die Norm selbst sollte gelegentlich nachweisen, weshalb sie überhaupt sinnvoll ist.
Warum muss Unterricht genau so organisiert sein? Weshalb gilt eine bestimmte Kommunikationsweise als professionell? Warum bewerten wir Aufmerksamkeit nach Sitzdauer und Produktivität nach Anwesenheit? Und weshalb sollte ein KI-System den häufigsten Fall automatisch als Referenz verwenden?
Manche Normen werden diese Prüfung bestehen. Andere werden sich als sinnvolle Kompromisse erweisen. Wieder andere existieren vermutlich hauptsächlich deshalb, weil man es schon immer so gemacht hat – jenem traditionsreichen Qualitätsmanagementverfahren, bei dem die Abwesenheit einer Begründung durch das Alter der Gewohnheit kompensiert wird.
Der Durchschnitt bleibt ein wertvolles statistisches Werkzeug. Er wird erst problematisch, wenn wir ihn zur Qualitätsnorm erheben.
Vielleicht sollten wir deshalb weniger darüber diskutieren, wie gut Menschen einer bestehenden Normalität entsprechen, und häufiger untersuchen, wie viel Verschiedenheit unsere Systeme produktiv integrieren können.
Das gilt für Schulen, Unternehmen und Verwaltungen ebenso wie für künstliche Intelligenz. Gerade Letztere könnte uns helfen, den statistischen Durchschnitt endlich als das zu behandeln, was er ist: eine Rechengröße, keine Instanz menschlicher Bewertung.
Die Diktatur beginnt nicht mit dem Durchschnitt. Sie beginnt, wenn wir ihm das Recht geben, über die Abweichenden zu urteilen.
